Eu argumento que Big Data se define melhor por
crowdledge (dos SANTOS, 2014a) do que pelos famosos 3 Vs: Volume de dados, Velocidade de processamento e Variedade dos tipos de dados.
Mas, o que é isso de
crowdledge?
Atualmente, o tempo todo deixamos pegadas digitais, trilhas de dados nos serviços digitais, sejam elas
ativas, quando lançamos a informação pessoal deliberadamente, com a finalidade de compartilhar informações sobre nós mesmos em redes sociais, por exemplo, ou
passivas, quando nossos dados são coletados por terceiros, sem qualquer atuação de nossa parte, tal como no uso do celular, câmaras de vigilância, etc.
Defino
crowdledge como o conhecimento
emergente e, portanto,
inesperado, a partir de análise Big Data de pegadas digitais espontâneas de indivíduos, deixadas em buscas no Google, posts no Facebook, Twitter, etc. (dos SANTOS, 2014). Está implícito que esse conhecimento emerge de dados referentes a
outro contexto.
Quando falo de
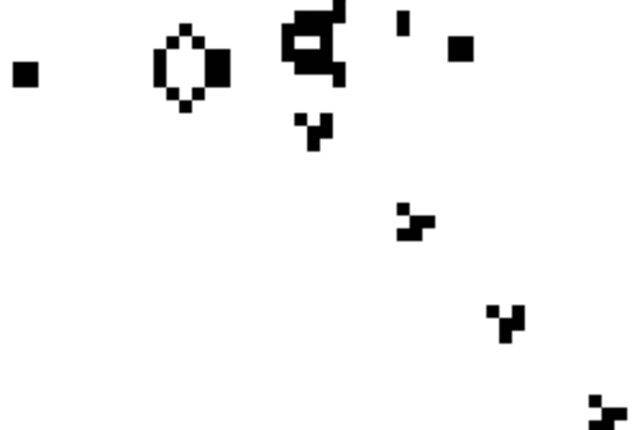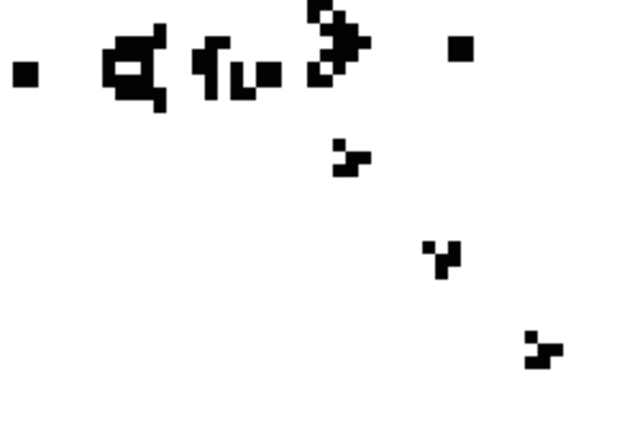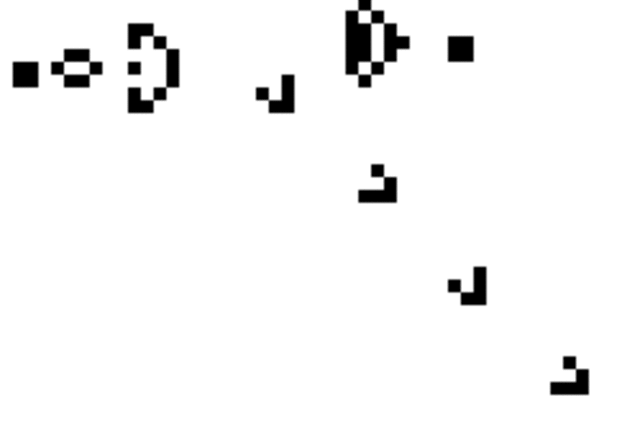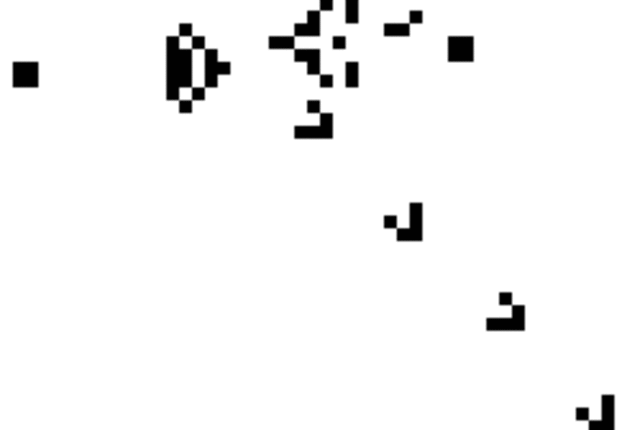
emergente, refiro-me ao conceito introduzido por Lewes (1875), referindo-se à formação de padrões e sistemas complexos a partir de uma grande quantidade de elementos relativamente simples em interação. Conceito este que tem sido aplicado em Filosofia, Teoria de Sistemas, Ciências e Artes. Um exemplo clássico é o
jogo da vida desenvolvido pelo matemático John Horton Conway, conforme a figura ao lado.
Assim, não se trata de
business intelligence (
inteligência empresarial) ou
data mining (
mineração de dados), pois não se está deliberadamente procurando extrair uma informação esperada e desejada pela administração de uma empresa, a partir de dados coletados dos clientes dessa mesma empresa.
Crowdledge não deve ser confundido com
inteligência coletiva, que tem mais a ver com um processo de tomada de decisão baseada no consenso (LÉVY, 1998).
Também não deve ser confundido com
wisdom of crowds (
sabedoria das multidões) (dos SANTOS, 2014), que tem mais a ver com a agregação das respostas intencionais de um grande grupo de pessoas a uma dada pergunta, visando uma resposta melhor do que a melhor resposta individual (SUROWIECKI, 205).
Um exemplo de
crowdledge seria o trabalho de Eagle, Macy e Claxton (2010), que conseguiram extrair dados sobre o desenvolvimento econômico de comunidades britânicas através de análise de Big Data de
registros de uma rede de comunicação telefônica do Reino Unido.
 |
| EAGLE; MACY; CLAXTON, 2010. |
Justamente por entender que Big Data se define melhor por
crowdledge é que acredito que Big Data tem interessantes aplicações como mediador no Ensino de Ciências, na forma de
pensar-com e
aprender-com-Big-Data, como já argumentei
anteriormente e como detalho em (dos SANTOS, 2014b).
Referências
- dos SANTOS, Renato P. Crowdsourcing, crowdfunding e crowdledge. Palestra presentada no evento 'Refletindo as pesquisas no PPGECIM', Ulbra/PPGECIM, Canoas, RS, 14 de agosto de 2014a.
- dos SANTOS, Renato P.; LEMES, Isadora L. Aprender-com-Big-Data no Ensino de Ciências. Acta Scientiae, v. 16, n. 4, 2014b.
- EAGLE, N.; MACY, M.; CLAXTON, R. Network diversity and economic development. Science, v. 328, n. 5981, p. 1029-1031, 2010.
- LÉVY, Pierre. A Inteligência Coletiva. São Paulo: Loyola, 1998.
- LEWES, G. H. Problems of Life and Mind. First series: The foundations of a creed ... Boston and New York: Houghton Mifflin Company, 1875. v. 2
- SUROWIECKI, J. The Wisdom of Crowds. New York: Doubleday, 2005.