segunda-feira, 23 de novembro de 2015

Big Data, comida e ciência no Coletivo Central em Porto Alegre.


Ricardo Cappra, Big Data, comida e Ciência no Coletivo Central em Porto Alegre Como as pessoas se relacionam com a comida? O que é mais procurado na área de gastronomia? Como funciona a interação dos indivíduos com os alimentos? Estas foram algumas questões discutidas durante...

quarta-feira, 22 de outubro de 2014

Big Data em uma nuvem de tags

Encontrei esta nuvem de tags (word cloud) sobre Big Data no relatório Big Data, Big Brains da MeryTalk.
Como se pode notar, demonstra uma concentração sobre o aspecto de volume de Big Data no entendimento geral do conceito.

Apesar disso, continuo insistindo que, na minha visão, Big Data tem menos a ver com os famosos 3 V's (volume, velocidade e variedade) e mais com crowdledge, que defino como o conhecimento emergente a partir de análise Big Data de pegadas digitais espontâneas de indivíduos, tais como buscas no Google, posts no Facebook, Twitter, etc.

segunda-feira, 1 de setembro de 2014

É crowdledge, Big Data!

Eu argumento que Big Data se define melhor por crowdledge (dos SANTOS, 2014a) do que pelos famosos 3 Vs: Volume de dados, Velocidade de processamento e Variedade dos tipos de dados.

Mas, o que é isso de crowdledge?

Atualmente, o tempo todo deixamos pegadas digitais, trilhas de dados nos serviços digitais, sejam elas ativas, quando lançamos a informação pessoal deliberadamente, com a finalidade de compartilhar informações sobre nós mesmos em redes sociais, por exemplo, ou passivas, quando nossos dados são coletados por terceiros, sem qualquer atuação de nossa parte, tal como no uso do celular, câmaras de vigilância, etc.

Defino crowdledge como o conhecimento emergente e, portanto, inesperado, a partir de análise Big Data de pegadas digitais espontâneas de indivíduos, deixadas em buscas no Google, posts no Facebook, Twitter, etc. (dos SANTOS, 2014). Está implícito que esse conhecimento emerge de dados referentes a outro contexto.

Quando falo de emergente, refiro-me ao conceito introduzido por Lewes (1875), referindo-se à formação de padrões e sistemas complexos a partir de uma grande quantidade de elementos relativamente simples em interação. Conceito este que tem sido aplicado em Filosofia, Teoria de Sistemas, Ciências e Artes. Um exemplo clássico é o jogo da vida desenvolvido pelo matemático John Horton Conway, conforme a figura ao lado.

Assim, não se trata de business intelligence (inteligência empresarial) ou data mining (mineração de dados), pois não se está deliberadamente procurando extrair uma informação esperada e desejada pela administração de uma empresa, a partir de dados coletados dos clientes dessa mesma empresa.

Crowdledge não deve ser confundido com inteligência coletiva, que tem mais a ver com um processo de tomada de decisão baseada no consenso (LÉVY, 1998).

Também não deve ser confundido com wisdom of crowds (sabedoria das multidões) (dos SANTOS, 2014), que tem mais a ver com a agregação das respostas intencionais de um grande grupo de pessoas a uma dada pergunta, visando uma resposta melhor do que a melhor resposta individual (SUROWIECKI, 205).

Um exemplo de crowdledge seria o trabalho de Eagle, Macy e Claxton (2010), que conseguiram extrair dados sobre o desenvolvimento econômico de comunidades britânicas através de análise de Big Data de registros de uma rede de comunicação telefônica do Reino Unido.

EAGLE; MACY; CLAXTON, 2010.
Justamente por entender que Big Data se define melhor por crowdledge é que acredito que Big Data tem interessantes aplicações como mediador no Ensino de Ciências, na forma de pensar-com e aprender-com-Big-Data, como já argumentei anteriormente e como detalho em (dos SANTOS, 2014b).

Referências
  • dos SANTOS, Renato P. Crowdsourcing, crowdfunding e crowdledge. Palestra presentada no evento 'Refletindo as pesquisas no PPGECIM', Ulbra/PPGECIM, Canoas, RS, 14 de agosto de 2014a.
  • dos SANTOS, Renato P.; LEMES, Isadora L. Aprender-com-Big-Data no Ensino de Ciências. Acta Scientiae, v. 16, n. 4, 2014b.
  • EAGLE, N.; MACY, M.; CLAXTON, R. Network diversity and economic development. Science, v. 328, n. 5981, p. 1029-1031, 2010.
  • LÉVY, Pierre. A Inteligência Coletiva. São Paulo: Loyola, 1998.
  • LEWES, G. H. Problems of Life and Mind. First series: The foundations of a creed ... Boston and New York: Houghton Mifflin Company, 1875. v. 2
  • SUROWIECKI, J. The Wisdom of Crowds. New York: Doubleday, 2005.

segunda-feira, 9 de junho de 2014

Piratas e aquecimento global?

No campo da ciência de dados, há uma velha piada sobre como a diminuição do número de piratas no mundo ao longo dos últimos 130 anos está causando o aquecimento global (HENDERSON, 2005). Já falei sobre isso anos atrás no meu site.
Este é um dos melhores exemplos de um dos erros mais comuns na lógica: confundir simultaneidade com causalidade. "Em outras palavras, assumir que, porque duas coisas estão acontecendo ao mesmo tempo, existe uma relação de causa e efeito entre elas" (ANDERSEN, 2012).


O Google Correlate, no entanto, não endossa essa correlação. Em vez disso, no site The Web Search Correlations Database, obtiveram-se sites de informação, tais como 'pacefire', 'ask.com', 'myspace.com', e 'kids.com' antes de 'emissões de dióxido de carbono', como os termos de busca mais altamente correlacionados.
Referências
  • ANDERSEN, E.. True Fact: The Lack of Pirates Is Causing Global Warming. Forbes - Blog. 23 mar. 2012. Disponível em: <http://www.forbes.com/sites/erikaandersen/2012/03/23/true-fact-the-lack-of-pirates-is-causing-global-warming/>. Acesso em: 9 jun. 2014.
  • HENDERSON, B.. Open Letter To Kansas School Board. jan. 2005. Disponível em: <http://www.venganza.org/about/open-letter/>. Acesso em: 14 mar. 2009.

segunda-feira, 2 de junho de 2014

Comparando temas escolares no Google Trends

Algumas correlações do site The Web Search Correlations Database, encontradas com o Google Correlate, exibem um gráfico característico, com um padrão semelhante ao que Mohebbi et al. (2011) observaram no termo de busca 'ribossomo': "a série de tempo para estas consultas apresentam picos no Outono e Primavera, quedas acentuadas durante a Ação de Graças e Natal e uma profunda queda no verão", o que os levou a argumentar que "isso reflete o ano letivo nos Estados Unidos e sugere que as consultas estão sendo conduzidos por classes escolares". Nós categorizamo-las naquele site como "temas escolares" (school topics).

Algumas delas foram "ribossomo', 'magnetismo','polarização' e 'equações diferenciais'. Usamos, então, o Google Trends para comparar os seus gráficos ao longo do tempo:

De fato, observa-se semelhança na periodicidade nas curvas do gráfico acima, o que parece corroborar a hipótese acima de Mohebbi et al. (2011).

Em outro post já havia feito uma comparação deste tipo entre os tópicos 'Química', 'Matemática', 'Biologia' e 'Física' e encontrado uma periodicidade semelhante, correspondente ao nosso calendário escolar.

Vale lembrar que nesse post também havia observado uma tendência de queda nas curvas dos gráficos e aventei as hipóteses de indicarem uma queda no interesse pelos estudos ou pelo próprio Google, hipóteses que foram descartadas numa atualização a esse post em que refiro à interpretação de Baram-Tsabari, Ayelet & Segev, Elad (2009).

Referências

quarta-feira, 28 de maio de 2014

Mitos de criação e blogs de arte

Outra correlação interessante do site The Web Search Correlations Database, é também baseada na dissertação de mestrado em Antropologia do afamado escritor norte-americano Kurt Vonnegut, na qual ele apresentou o que chamou de story shapes, gráficos que, segundo ele, poderiam representar graficamente um enredo (VONNEGUT, 1999, apud KLEON, 2005).

Desta vez, Kleon introduziu no Google Correlate um esboço do gráfico que, para Vonnegut, representa os "mitos de criação", em geral (VONNEGUT, 1999, apud KLEON, 2005), obtendo 'blog de arte' como o termo de busca mais altamente correlacionado (KLEON, 2011).


Kleon explica este gráfico de "mito de criação" como representando uma narrativa "na qual um deus de algum tipo dá ao povo o sol, depois a lua, depois o arco, a flecha, o milho, e assim por diante, sendo, essencialmente, uma escada, uma narrativa de acumulação" (Kleon, 2005).

Referências

terça-feira, 27 de maio de 2014

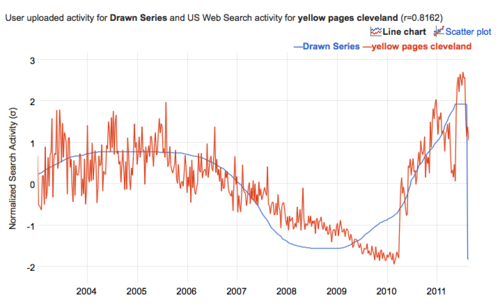
Rapaz encontra garota e as páginas amarelas de Cleveland

Outra correlação interessante do site The Web Search Correlations Database, é também baseada na dissertação de mestrado em Antropologia do afamado escritor norte-americano Kurt Vonnegut, na qual ele apresentou o que chamou de story shapes, gráficos que, segundo ele, poderiam representar graficamente um enredo (VONNEGUT, 1999, apud KLEON, 2005).

Desta vez, Kleon introduziu no Google Correlate um esboço do gráfico que, para Vonnegut, representa o enredo "rapaz encontra garota, rapaz perde a garota, rapaz consegue a garota de volta" (VONNEGUT, 1999, apud KLEON, 2005), obtendo 'páginas amarelas de Cleveland' como o termo de busca mais altamente correlacionado (KLEON, 2011).

Referências