Mostrando postagens com marcador correlações. Mostrar todas as postagens

segunda-feira, 9 de junho de 2014

Piratas e aquecimento global?

No campo da ciência de dados, há uma velha piada sobre como a diminuição do número de piratas no mundo ao longo dos últimos 130 anos está causando o aquecimento global (HENDERSON, 2005). Já falei sobre isso anos atrás no meu site.
Este é um dos melhores exemplos de um dos erros mais comuns na lógica: confundir simultaneidade com causalidade. "Em outras palavras, assumir que, porque duas coisas estão acontecendo ao mesmo tempo, existe uma relação de causa e efeito entre elas" (ANDERSEN, 2012).


O Google Correlate, no entanto, não endossa essa correlação. Em vez disso, no site The Web Search Correlations Database, obtiveram-se sites de informação, tais como 'pacefire', 'ask.com', 'myspace.com', e 'kids.com' antes de 'emissões de dióxido de carbono', como os termos de busca mais altamente correlacionados.
Referências
  • ANDERSEN, E.. True Fact: The Lack of Pirates Is Causing Global Warming. Forbes - Blog. 23 mar. 2012. Disponível em: <http://www.forbes.com/sites/erikaandersen/2012/03/23/true-fact-the-lack-of-pirates-is-causing-global-warming/>. Acesso em: 9 jun. 2014.
  • HENDERSON, B.. Open Letter To Kansas School Board. jan. 2005. Disponível em: <http://www.venganza.org/about/open-letter/>. Acesso em: 14 mar. 2009.

segunda-feira, 2 de junho de 2014

Comparando temas escolares no Google Trends

Algumas correlações do site The Web Search Correlations Database, encontradas com o Google Correlate, exibem um gráfico característico, com um padrão semelhante ao que Mohebbi et al. (2011) observaram no termo de busca 'ribossomo': "a série de tempo para estas consultas apresentam picos no Outono e Primavera, quedas acentuadas durante a Ação de Graças e Natal e uma profunda queda no verão", o que os levou a argumentar que "isso reflete o ano letivo nos Estados Unidos e sugere que as consultas estão sendo conduzidos por classes escolares". Nós categorizamo-las naquele site como "temas escolares" (school topics).

Algumas delas foram "ribossomo', 'magnetismo','polarização' e 'equações diferenciais'. Usamos, então, o Google Trends para comparar os seus gráficos ao longo do tempo:

De fato, observa-se semelhança na periodicidade nas curvas do gráfico acima, o que parece corroborar a hipótese acima de Mohebbi et al. (2011).

Em outro post já havia feito uma comparação deste tipo entre os tópicos 'Química', 'Matemática', 'Biologia' e 'Física' e encontrado uma periodicidade semelhante, correspondente ao nosso calendário escolar.

Vale lembrar que nesse post também havia observado uma tendência de queda nas curvas dos gráficos e aventei as hipóteses de indicarem uma queda no interesse pelos estudos ou pelo próprio Google, hipóteses que foram descartadas numa atualização a esse post em que refiro à interpretação de Baram-Tsabari, Ayelet & Segev, Elad (2009).

Referências

quarta-feira, 28 de maio de 2014

Mitos de criação e blogs de arte

Outra correlação interessante do site The Web Search Correlations Database, é também baseada na dissertação de mestrado em Antropologia do afamado escritor norte-americano Kurt Vonnegut, na qual ele apresentou o que chamou de story shapes, gráficos que, segundo ele, poderiam representar graficamente um enredo (VONNEGUT, 1999, apud KLEON, 2005).

Desta vez, Kleon introduziu no Google Correlate um esboço do gráfico que, para Vonnegut, representa os "mitos de criação", em geral (VONNEGUT, 1999, apud KLEON, 2005), obtendo 'blog de arte' como o termo de busca mais altamente correlacionado (KLEON, 2011).


Kleon explica este gráfico de "mito de criação" como representando uma narrativa "na qual um deus de algum tipo dá ao povo o sol, depois a lua, depois o arco, a flecha, o milho, e assim por diante, sendo, essencialmente, uma escada, uma narrativa de acumulação" (Kleon, 2005).

Referências

terça-feira, 27 de maio de 2014

Rapaz encontra garota e as páginas amarelas de Cleveland

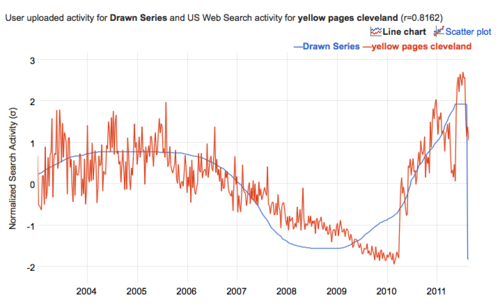
Outra correlação interessante do site The Web Search Correlations Database, é também baseada na dissertação de mestrado em Antropologia do afamado escritor norte-americano Kurt Vonnegut, na qual ele apresentou o que chamou de story shapes, gráficos que, segundo ele, poderiam representar graficamente um enredo (VONNEGUT, 1999, apud KLEON, 2005).

Desta vez, Kleon introduziu no Google Correlate um esboço do gráfico que, para Vonnegut, representa o enredo "rapaz encontra garota, rapaz perde a garota, rapaz consegue a garota de volta" (VONNEGUT, 1999, apud KLEON, 2005), obtendo 'páginas amarelas de Cleveland' como o termo de busca mais altamente correlacionado (KLEON, 2011).

Referências

segunda-feira, 26 de maio de 2014

Desenvoltura e hemorróidas

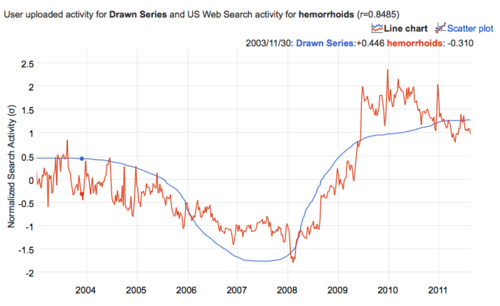
Outra correlação interessante do site The Web Search Correlations Database, é baseada na dissertação de mestrado em Antropologia do afamado escritor norte-americano Kurt Vonnegut, na qual ele apresentou o que chamou de story shapes, gráficos que, segundo ele, poderiam representar graficamente um enredo (VONNEGUT, 1999, apud KLEON, 2005).

Kleon introduziu no Google Correlate um esboço do gráfico que, para Vonnegut, representa o enredo "pessoa que está levando uma vida suportável, experimenta um infortúnio, vence o infortúnio e fica mais feliz depois, por ter demonstrado desenvoltura e força" (VONNEGUT, 1999, apud KLEON, 2005), obtendo 'hemorróidas' como o termo de busca mais altamente correlacionado (KLEON, 2011).

Referências

domingo, 25 de maio de 2014

Previsões de desemprego

Outra correlação interessante do site The Web Search Correlations Database, encontrada por Justin Wolfers, foi que os dados de 'Initial unemployment claims' (índice norte-americano de desemprego) correlacionam-se muito bem com 'filing for unemployment' (pedidos de auxílio desemprego) (WOLFERS, 2011).
A partir disso, Wolfers previu "que os índices de desemprego iriam cair a partir das próximas semanas [após o fim de maio de 2011]" (WOLFERS, 2011), o que realmente ocorreu.

Referências

quinta-feira, 22 de maio de 2014

Cerveja e fraldas

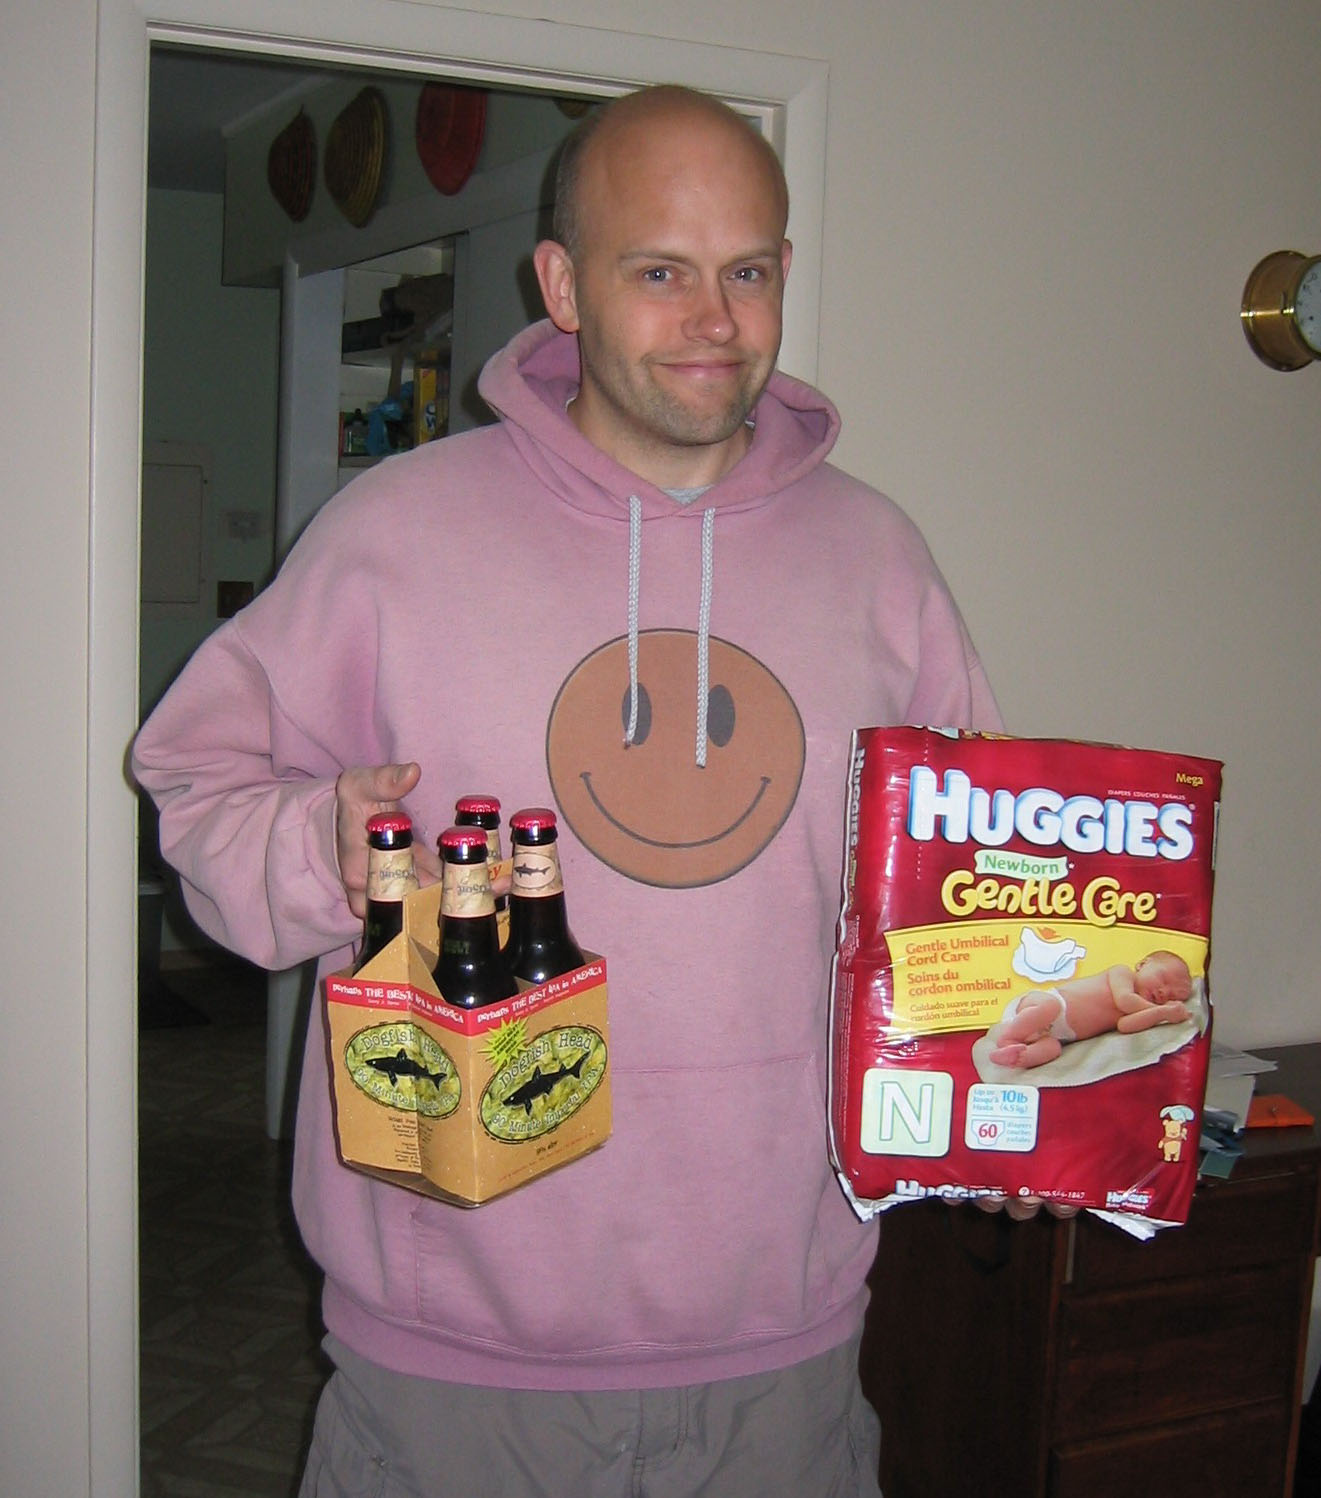
No campo da ciência de dados, há uma história muito citada de como uma grande cadeia de supermercados norte-americana descobriu uma forte associação para muitos clientes entre uma marca de fraldas e uma marca de cerveja e foi capaz de explorá-la movendo os produtos para mais juntos entre si nas suas prateleiras para aumentar as vendas.
O Google Correlate, no entanto, não endossa essa correlação. Em vez disso, para o termo de busca 'fraldas', no site The Web Search Correlations Database, obteve-se 'porta TCP 5000', 'o chamado caos', 'Letizia Ortiz', 'Tettnang', 'Terra Lycos' e 'Ernest Hollings' como os termos de busca mais altamente correlacionados.
Parece que lá em maio de 2004, os orgulhosos novos pais eram mais moderados em seus hábitos e mais preocupados com alguma vulnerabilidade de segurança na sua porta TCP 5000, com o casamento da princesa de Astúrias, com o lançamento do sistema operacional Fedora, ou com o controverso editorial de Hollings sobre a invasão do Iraque, do que com cerveja.

segunda-feira, 12 de maio de 2014

Ribossomos, mitocondrias, cloroplastos e o calendário escolar

Outra correlação interessante do site The Web Search Correlations Database, encontrada pelo próprio Mohebbi, um dos principais criadores do Google Correlate, foi que o termo de busca 'ribosome' correlaciona-se muito bem com mitochondria', 'cell wall', 'chloroplasts', 'chromatin' e 'plant cells'.


Analisando o gráfico obtido, Mohebbi et al. (2011) observaram que "a série de tempo para estas buscas apresentam picos no Outono e Primavera [no Hemisfério Norte], quedas acentuadas durante os feriados de Ação de Graças e Natal e uma longa queda no verão". Conclui ele, assim, que isso reflete o ano letivo nos EUA e sugere que as consultas estão sendo derivadas pelas aulas de Biologia.

Referências


terça-feira, 6 de maio de 2014

O acidente com o reator nuclear de Fukushima

Outra correlação interessante do site The Web Search Correlations Database, encontrada com o Google Correlate, foi que os termos de busca 'radiation' e 'nuclear radiation', que tiveram um enorme pico em 13 mar. 2011, derivado, certamente, do acidente com o reator nuclear de Fukushima nessa data.

segunda-feira, 5 de maio de 2014

Termodinâmica e Shirley Jackson alcançaram o máximo da fama em 2 fev 2014

Outra correlação interessante do site The Web Search Correlations Database, encontrada com o Google Correlate, foi que os termos de busca 'Termodinâmica' e a escritora norte-americana Shirley Jackson tiveram um pico em 2 fev 2014.


No entanto, não fomos capazes de encontrar qualquer explicação para isso.

domingo, 4 de maio de 2014

Velocidade máxima dos ventos e furacões no Oceano Atlântico

Outra correlação interessante do site The Web Search Correlations Database, encontrada com o Google Correlate, foi encontrada por Peter Aldhous entre 'velocidade máxima dos ventos' e 'furacões no Oceano Atlântico' em 2011:

quinta-feira, 1 de maio de 2014

Justin Bieber causa amigalite?

Uma correlação divertida do site The Web Search Correlations Database, encontrada com o Google Correlate, é a entre o termo de busca [Justin] 'Bieber' e tonsilite (amigdalite), encontrada por Nick Douglas.


É claro que "correlação não implica em causação", como todo estatístico sabe, mas o Nick brinca com essa ideia, sugerindo que o Justin Bieber cause amigdalite em adultos. Talvez se fosse otite ou náuseas...

Referências

quarta-feira, 30 de abril de 2014

As fases da Lua e a cultura hindu

Continuando com as correlações encontradas com o Google Correlate, vale a pena mencionar esta, do site The Web Search Correlations Database.

Carreguei os dados da fase da Lua a partir dos dados da USNO e obtive 'waning gibbous', 'Sankashti Chaturthi' e 'Sankatahara Chaturthi' como os termos de busca mais altamente correlacionados.


Para quem não está familiarizado com a cultura hindu, Sankashti Chaturthi, também conhecido como Sankata Hara Chaturthi, é um dia considerado auspiciouso e dedicado ao Senhor Ganesha. este dia é celebrado todos os meses lunares ou em todos os meses do calendário hindu no quarto dia da fase lunar, isto é, na chamada 'Lua minguante convexa' ou, em inglês, waning 'gibbous moon'.

Referências

sexta-feira, 25 de abril de 2014

O site The Web Search Correlations Database

Eu já postei aqui algumas correlações interessantes encontradas com a ferramenta Google Correlate.

Há menos de um mês, criei o site The Web Search Correlations Database, o qual pretende, como o nome diz, ser uma base de dados dessas correlações.

Aqui irei postando, então, essas correlações à medida que as for encontrando.

Por exemplo, hoje incluí lá a correlação encontrada por Peter Aldhous entre 'lesões por tornados' e 'notícias sobre tornados' em 2011:

segunda-feira, 2 de dezembro de 2013

Fazendo Big Data do Twitter com o R Studio

Ontem comecei a aprender a linguagem de programação R para cálculos estatísticos e visualizações de dados. Seu código fonte está disponível sob a licença GNU GPL e é hoje  amplamente usada entre estatísticos e data miners para desenvolver software de estatística e análise de dados.

Estou estudando com o excelente livro-texto 'An Introduction to Data Science', desenvolvido por Jeffery Stanton para a Pós em Data Science da Universidade de Syracuse. Ele está disponível em formato .pdf no site Teach Data Science.


Na verdade, estou usando o R Studio, um IDE (ambiente de desenvolvimento integrado) open source para R.


Dentro do R Studio, existe o pacote twitteR, criado por Jeff Gentry, que oferece uma interface muito simples para extrair listas de tweets, selecionados por algum critério, diretamente do Twitter para dentro de R. Após obtida, essa lista pode facilmente ser transformada em um dataframe.

Como um exercício, extraí para o R Studio tweets contendo a palavra 'Ulbra' (não apenas a hashtag #Ulbra), obtendo 299 tweets nos últimos 7 dias (restrição imposta aos APIs que acessam a timeline do Twitter).

Após algumas preparações no texto dos tweets, realizadas com recursos do twitteR, mandei-o construir a nuvem de tags (tag cloud) correspondente:


Infelizmente, não consegui ainda fazê-lo trabalhar corretamente com palavras acentuadas em português, mas já dá para ter uma ideia de quais assuntos os tuiteiros andam falando com relação à Ulbra.

O próximo passo é fazer análises de sentimento desses tuítes.

segunda-feira, 17 de junho de 2013

Big Data ou Admirável Gado Novo?

Voltando à ferramenta Google Correlate que eu já havia abordado em post anterior, andei fazendo mais algumas experiências, com resultados curiosos:

Por exemplo, introduzi dados temporais gerados com a função do Excel 'fração do ano' que retorna a fração de dias que resta do ano em qualquer data. Ela produz um gráfico em forma de dente-de-serra, com máximo em 1 de janeiro e mínimo em 31 de dezembro.

O termo de busca que melhor se correlacionou (com um R^2 de 0.8907) foi 'mother of the bride' (mãe da noiva), seguido de 'bride dresses' (vestidos de noiva), 'flower girl dresses' (vestidos para aia) e outros relacionados com a cerimônia de casamento, como se vê da lista abaixo.

Temos de busca no Google cujas frequências melhor se correlacionam com os dados temporais 'fração do ano'

O gráfico abaixo mostra a correlação com o termo 'mother of the bride' (mãe da noiva)

Gráfico da correlação entre dados temporais de 'fração do ano' e 'mother of the bride' no Google Correlate
Parece que nos EUA, a maior preocupação no Ano Novo é com vestidos de casamento, etc.

Quando usei os mesmo dados para o Brasil, obtive que os termos de busca que melhor se relacionam são 'emprego', 'carteirinha' (de estudante), 'queda de cabelo', 'alistamento militar', etc.

Temos de busca no Google cujas frequências melhor se correlacionam no Brasil com os dados temporais 'fração do ano'
com o correspondente gráfico

Gráfico da correlação entre dados temporais de 'fração do ano' e 'emprego' no Google Correlate no Brasil

Parece que as preocupações de Ano Novo dos brasileiros são bem diferentes das dos norte-americanos.

Outra experiência que fiz foi com os dados 'winter wave' do próprio Google Correlate, cujo gráfico é uma cossenoide com máximo no início do inverno e mínimo no início do verão.

Os termos que melhor se correlacionam são 'Nordica' e 'Dalbello' (conhecidas marcas de esquis), seguidos por 'wedding soup' (uma típica sopa italiana de natal), 'colds' (resfriado), etc.

Temos de busca no Google cujas frequências melhor se correlacionam com os dados temporais 'winter wave'
com o gráfico
Gráfico da correlação entre dados temporais de 'winter wave' e 'Nordica' no Google Correlate
O mesmo conjunto de dados aplicado ao Brasil resulta em termos associados a destinos de férias de verão, etc.

Temos de busca no Google no Brasil cujas frequências melhor se correlacionam com os dados temporais 'winter wave'
com o gráfico

Gráfico da correlação entre dados temporais de 'winter wave' e 'Punta del Este' no Google Correlate no Brasil
Aproveitando a ideia, produzi os dados inversos, isto é, 'summer wave', que inseridos no Google Correlate, resultam nos termos de busca 'golf course' (percurso de golfe), 'tent' (tenda), 'dunk tank' (jogo de parques de diversão que faz uma garota cair num tanque d'água quando se acerta) e outros relacionados a atividades de férias de verão.

Temos de busca no Google cujas frequências melhor se correlacionam com os dados temporais 'summer wave'
com o gráfico abaixo para percurso de golfe.

Gráfico da correlação entre dados temporais de 'summer wave' e 'golf course' no Google Correlate
Aplicando os mesmos dados 'summer wave' para o Brasil, obtemos termos de busca principalmente associados a 'festa do peão', etc.

Temos de busca no Google no Brasil cujas frequências melhor se correlacionam com os dados temporais 'summer wave'
com o gráfico para 'peão'

Gráfico da correlação entre dados temporais de 'summer wave' e 'peão' no Google Correlate no Brasil
Outra experiência foi uma série de dados senoidal com máximo no início da primavera do hemisfério norte (início do nosso outono) que, no Brasil, correlaciona aos termos de busca 'queda de cabelo' (!?), 'vestibular de meio de ano', 'moda outono', etc.

Temos de busca no Google no Brasil cujas frequências melhor se correlacionam com os dados temporais 'spring wave'

Finalmente, outra experiência foi com uma série de dados senoidal com máximo no início do outono do hemisfério norte (início da nossa primavera) que, no Brasil, correlaciona aos termos de busca 'moda verão', 'moda primavera', 'inscrição vestibular', etc.


Concluo, com tudo isso, que, embora tenhamos plena liberdade de escolha em nossas buscas no Google, afinal somos, em conjunto, muito previsíveis.

Eh, ôô, vida de gado

como cantava Zé Ramalho em seu Admirável Gado Novo!

terça-feira, 11 de junho de 2013

Big Data e Google Correlate comprovam falha de resoluções de ano novo?


Como se sabe, o Google não apenas realiza alegadas cem bilhões de pesquisas mensais de termos na Web (SULLIVAN, 2012), como as armazena todas, identificadas por hora e local de origem em seus gigantescos data centers ao redor do mundo. Essas informações são utilizadas pelos programas de publicidade geridos pelo Google, tais como DoubleClick, Google Analytics, Google AdWords e Google AdSense, de onde provêm mais de 90% da renda da empresa Google (GOOGLE Inc., 2013).

Já há alguns anos, a Google disponibiliza a ferramenta Google Correlate que mencionei rapidamente no post passado. Trata-se de (mais) um projeto experimental do extinto Google Labs. 

Nele, introduz-se uma série de dados temporais ou regionais e se obtém uma lista das consultas no Google cujas frequências seguem padrões que melhor se correlacionam com os dados, segundo o coeficiente de determinação R^2 (MOHEBBI et al., 2011). 

Tenho brincado com essa ferramenta há algumas semanas e obtido resultados no mínimo curiosos.

Hoje, por acaso, testei a sugestão 'losing weight' (perder peso) do próprio Google Correlate.

O termo de busca que melhor se correlacionou (com um R^2 de 0.9672) foi 'workouts' (exercícios ou sessões de treinos), o que é bem razoável.

O que me chamou a atenção, no entanto, foi o gráfico dessa correlação:

Gráfico da correlação entre losing weight e workouts no Google Correlate
Observe a queda no ritmo dos treinos ao longo de cada ano, as 'quedas em tentação' a cada final de ano e as abruptas retomadas a cada início de ano!

Parece que há, realmente, uma síndrome de 'resoluções de Ano Novo', especialmente a que inclui a fatídica 'perder peso'!

sexta-feira, 17 de maio de 2013

Big Data (errado) na capa da VEJA desta semana

Como muitos já devem ter visto, a revista VEJA desta semana destaca o Big Data na capa.


Podia ser interessante, mas começa mal.

A figura estranha na capa é o norte-americano A. J. Jacobs.

Não sei de onde a VEJA tirou que ele é o "Mr. Big Data" (podem procurar no Google)!

Graças ao TinEye, descobri que essa imagem aparece no livro The Human Face of Big Data do fotógrafo Rick Smolan que reúne histórias e fotos relacionadas à 'Revolução da Big Data'.


O Jacobs foi incluído no livro por sua história de gostar de monitorar dezenas de suas variáveis corporais, tais como sua pulsação, pressão, qualidade de sono, passos dados, humor, etc.

Embora o Jacobs deva estar gerando grandes quantidades de dados, ele não está fazendo grandes análises deles e, por isso, não se qualifica para Big Data, e, certamente, muito menos para Mr. Big Data!

Para quem pretendia entender o que é o Big Data, a VEJA forneceu apenas a visão que se resume aos famosos três V's: grande Volume de dados, grande Velocidade possível e necessária para processá-los e sua Variedade, por provir de fontes diversas, tais como emails, blogs e redes sociais, arquivos de vídeo, etc.

Esta é a versão hype (oba-oba) e distorcida de que as grandes fabricantes (IBM, Microsoft, etc.) estão usando para vender equipamentos e serviços caríssimos para as empresas desavisadas que querem, com eles, ficarem 'modernas'.

A VEJA se esqueceu de falar dos outros dois V's igualmente importantes:
  • Veracidade: é necessário que os dados sejam autênticos e façam sentido (HURWITZ et al., 2013, p. 16);
  • Valor: é fundamental que os dados acrescentem valor ao seu utilizador (BEULKE, 2011), para que o enorme investimento necessário para o Big Data não seja uma despesa inútil.
Mas, pior, ainda, a VEJA também não discutiu uma série de mitos sobre o Big Data (ver, por exemplo, CRAWFORD, 2013), tais como

  • a falsa 'garantia' de que os dados serão anonimizados antes de serem processados, já que já foi demonstrado que geralmente é possível desanonimizar os dados por cruzá-los com outras bases de dados;
  • a falsa promessa de que o Big Data vai mudar nossas vidas para melhor, sabendo que muito do que se faz com ele é aperfeiçoar os mecanismos de nossa incitação ao consumo;
  • a falsa ideia de que Big Data é o futuro da Ciência, o quinto paradigma, de que "com dados suficientes, os números falam por si", descartando a necessidade de modelos, teorias, análise crítica, etc. Na verdade, os números, poucos ou muitos, nunca falam; é a mente humana que lhes dá significado.
    Big Data como um novo paradigma
    Fonte: (ZHU, 2013)
Um dos exemplos mais famosos é o Google Flu Trends (tendências da gripe), baseado no trabalho de Ginsberg et al. (2009), publicado na prestigiosa revista Nature, em que esses autores utilizaram-no para rastrear afecções semelhantes à gripe na população dos EUA.

No entanto, em 2013, o Google previu um surto de gripe com quase o dobro da intensidade reportada pelas autoridades norte-americanas. Vários pesquisadores sugerem que uma ampla cobertura da mídia sobre a severa temporada de gripe, incluindo uma declaração de emergência de saúde pública pelo estado de Nova York, teria provocado um grande aumento nas pesquisas relacionadas à gripe por pessoas que não estavam doentes e, com isso, causado um processo de realimentação nas previsões do Google (BUTLER, 2013).

Por outro lado, um exemplo bem sucedido de Big Data Science é o da recente identificação do Bóson de Higgs pelo LHC, o qual teve que utilizar um sistema Hadoop de computação distribuída, típico de Big Data, para gerenciar todos os dados.

Não vislumbro motivo para que a produção de dados digitais tenda a diminuir. Com isso, ainda que a moda do Big Data seja substituída pela next big thing, certamente a Ciência e a Economia necessitarão de algum tipo de análise dessas enormes massas de dados.

Da minha experiência, observo que produzir perguntas é um desafio maior do que obter respostas a elas com essas ferramentas do Big Data.

Aqui, acredito, é que os profissionais de Ciências são mais necessários.

Acredito, também, que, com ferramentas públicas e gratuitas, tais como o Microsoft GeoFlow, o Google Trends, o Google Correlate e outras que vierem a surgir em breve, os estudantes, futuros profissionais de Ciências, podem se familiarizar com os desafios científicos e éticos propostos pelo Big Data.

Referências

  • BEULKE, D. Big Data Impacts Data Management: The 5 Vs of Big Data [Blog post]. Disponível em: <http://davebeulke.com/big-data-impacts-data-management-the-five-vs-of-big-data/>. Acesso em: 7/5/2013.
  • BUTLER, D. When Google got flu wrong. Nature, v. 494, n. 7436, p. 155–156, 2013. Disponível em: <http://www.nature.com/news/when-google-got-flu-wrong-1.12413>. Acesso em: 16/5/2013.
  • CRAWFORD, K. Think Again: Big Data. Foreign Policy, 9. May. 2013. Disponível em: <http://www.foreignpolicy.com/articles/2013/05/09/think_again_big_data>. Acesso em: 13/5/2013.
  • GINSBERG, J.; MOHEBBI, M. H.; PATEL, R. S. et al. Detecting influenza epidemics using search engine query data. Nature, v. 457, n. 7232, p. 1012–4, 2009. Disponível em: <http://www.ncbi.nlm.nih.gov/pubmed/19020500>. Acesso em: 28/4/2013.
  • HURWITZ, J.; NUGENT, A.; HALPER, F.; KAUFMAN, M. Big Data for Dummies. Hoboken, NJ: John Wiley & Sons, 2013.
  • ZHU, J. Big Data for Social Science Research: Hypes, Myths, and Realities. 21. Jan. 2013. Kowloon Tong, Hong Kong: City University of Hong Kong. Disponível em: <http://com.cityu.edu.hk/COMDOC/Seminar/ppt/2013/seminarPPT-2013-01-21.pdf>

sexta-feira, 10 de maio de 2013

Big Data ou Big Brother?

Estava lendo hoje o relatório Big Data, Big Impact: New Possibilities for International Development, publicado em 2012 pelo Fórum Econômico Mundial, de Davos.

Nele, argumenta-se que os dados provenientes de telefones celulares tem interesse especial, porque, para muitas pessoas de baixa renda, esta é a sua única forma de tecnologia interativa e, ao mesmo tempo, com ela é mais fácil de identificar os indivíduos aos dados. Com isso, esses dados poderiam pintar um quadro sobre as necessidades e comportamentos dos usuários individuais, em vez de simplesmente sobre a população como um todo.

Esse documento cita também uma pesquisa, segundo a qual, quando os operadores de telefonia móvel observam uma redução do tempo de antena em uma determinada região, isso tende a indicar uma perda de renda nessa população muito antes que essa informação apareça nos indicadores oficiais.

Em outra pesquisa citada, conversas relacionadas com a alimentação no Twitter não só mostraram correlações muito fortes com a inflação dos preços dos alimentos, como puderam indicar onde e como as pessoas já estavam mudando seu comportamento em função disso.

Segundo Kikpatric, no auge da crise financeira global de 2009, o Secretário-Geral das Nações Unidas criou a iniciativa Global Pulse, como um laboratório de pesquisa de desenvolvimento, para descobrir se o Big Data e sua análise em tempo real poderiam ajudar a tornar a formulação de políticas mais ágil e eficaz.

O relatório Big Data afirma que a Global Pulse está se envolvendo ativamente no que seu diretor, Robert Kirkpatrick, chama de ‘filantropia de dados’, onde empresas parceiras são incentivadas a compartilhar dados anonimizados para uso do setor público para proteger as populações vulneráveis.

Confesso que me assustei um pouco com a conclusão do relatório:

"Apesar dos desafios [da falta de especialistas e resistência das empresas em compartilhar os dados] e riscos [com privacidade e segurança], as oportunidades disponíveis para melhor servir as pessoas nos mercados emergentes devem compensar esses riscos" [grifo meu].

E mais ainda quando li que Kikrpatric afirma que

"Big Data é uma matéria prima pública, e devemos trabalhar juntos para encontrar maneiras de aproveitá-la para um massivo impacto social, tanto de forma segura quanto responsável. Para que isso aconteça, a ‘filantropia de dados’ tem que se tornar uma prioridade do setor privado" [grifo meu].

Ou seja, devemos permitir -- compulsoriamente até, se for o caso -- a abertura de nossos dados pessoais de identificação e comunicação, abrir mão da nossa privacidade e segurança, porque 'eles', o Grande Irmão, garantem que vai ser bom para todos nós!


Veja também meu post O que a Ciência pode aprender com o Google?

sexta-feira, 26 de abril de 2013

O que a Ciência pode aprender com o Google?

Desde os tempos de Francis Bacon que a Ciência segue o proclamado método científico: um fenômeno chama a atenção de um cientista que formula uma teoria, uma tentativa de explicação desse fenômeno, dessa teoria, deriva hipóteses e previsões que podem ser testadas experimentalmente; caso os resultados sejam satisfatórios, a teoria é considerada uma boa explicação do fenômeno numa relação causal, ou seja, tais e quais fatores, intervindo numa certa relação, causam o fenômeno.

O Google, a gigante das pesquisas na web, tem seu grande trunfo em descobrir quais as 'melhores' páginas para cada determinado assunto; e faz bilhões de dólares com seus acertos. No entanto, o Google é como um papagaio que repete palavras sem saber seu significado: a máquina por trás dessa pesquisa não tem recursos de análise semântica, isto é, não faz a menor ideia do significado do texto da página, e também não faz análise causal do porquê seus utilizadores preferem uma página do que outra. Usando uma simples estatística, o Google simplesmente atribui um grau maior de relevância nas listas de resultados às páginas mais visitadas e com maior tempo de permanência do leitor. É dessa mesma maneira que o Google consegue traduzir Klingon para Farsi quase tão bem quanto francês para alemão, sem realmente "conhecer" nenhum desses idiomas.

Só hoje li o interessante artigo The End of Theory: The Data Deluge Makes the Scientific Method Obsolete (O Fim da Teoria: O Dilúvio de dados torna o método científico obsoleto) na Wired, onde Chris Anderson, editor chefe da revista, argumenta que, na nossa atual era de petabytes de informação, aquela clássica abordagem - hipótese, modelo, teste - está se tornando obsoleta.

Agora que podemos analisar amostras imensas, quando não o próprio universo de dados, a tendência seria cada se vez mais se fazer Ciência à maneira do Google: as correlações aí observadas adquiririam validade por si só e poderiam dispensar causalidades, modelos coerentes, teorias unificadas ou qualquer explicação mecanicista de todo!

Segundo o autor, seria a hora de perguntar: o que a Ciência pode aprender com o Google?

Veja também meu post Em tempos de Big Data, grande educação?